Importação dos Dados para Bancos Relacionais e NoSQL
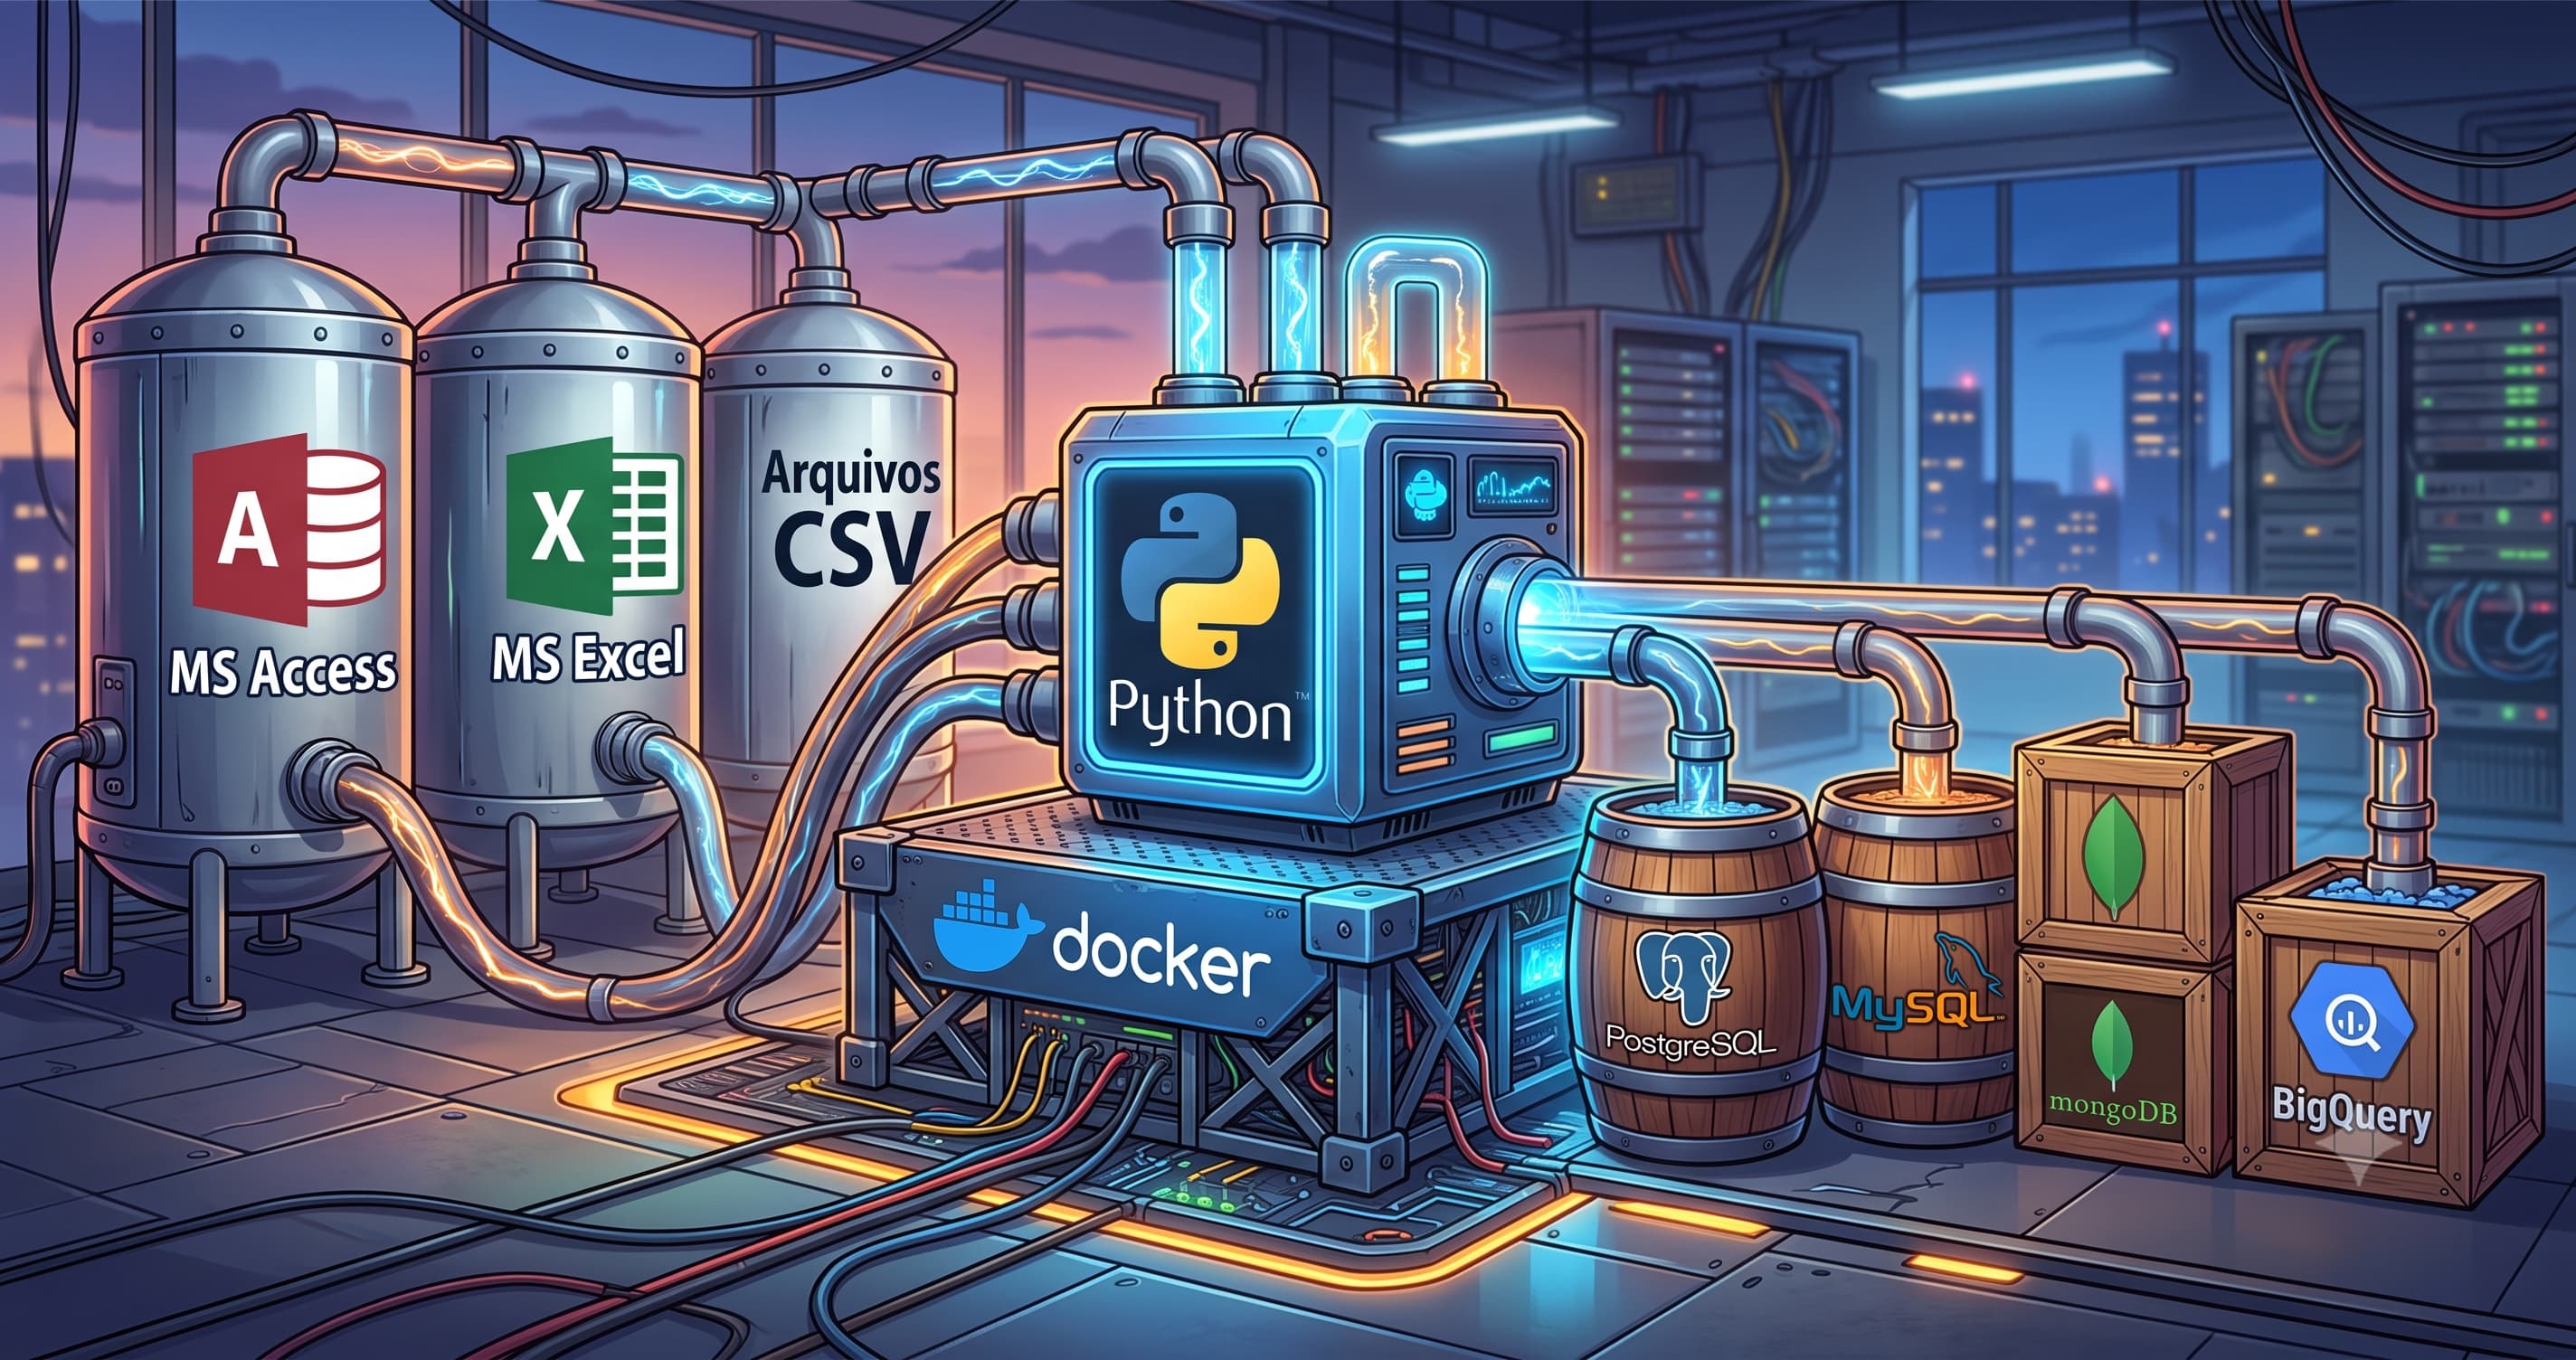
Neste percurso eu pretendo comparar o tempo de importação dos dados para o MySQL, PostgreSQL, MongoDB e BigQuery.
O objetivo é avaliar não apenas a velocidade, mas também a facilidade de modelagem, o custo de armazenamento e a flexibilidade para consultas analíticas.
No entanto, já tenho algum tempo te tecnologia e sei que uma vez um software instalado em nossos PCs sempre ficam alguns vestígios, como todo o nosso processo de ingestão de dados serão criados por nós, vamos fazer uso das ferramentas para tentar ser o mais "limpo" possível de maneira que não fiquemos instalando softwares e bibliotecas que não pretendemos utilizar novamente, pelo menos não tão cedo, então o processo de importação será executado em um container docker, o docker é uma ferramenta maravilhosa e foi criada exatamente para este cenário onde os desenvolvedores falavam "na minha máquina funciona", então aqui vai funcionar tanto na minha máquina quanto na sua e ainda por cima vamos ter tudo limpinho sem um monte de bibliotecas instaladas no repositórios de nossas máquinas sem necessidade.
Começando pelo começo, instale o docker se já não tem, aí você diz "não é para não instalar as coisas", pois bem, tudo tem um custo e o docker você vai aprender a amar, eu garanto, se você de fato for trabalhar com TI poderá até briar por sistema operacional ou lingaguem de programação, mas o docker é uma unanimidade.
Depois de instalado o docker, vamos criar os nossos servidores, primeiro o MySQL pois na minha vida profissional até agora foi ele quem mais pagou as minhas contas.
Vamos dizer que você tenha instalado docker, mas que ainda não é muito experiente, como estamos lidando com um ambiente onde vamos trabalhar com muita informação e esta informação ainda por cima pode ser repliada muitas vezes, então vamos precisar de armazenamento extra, geralmente as máquinas não tem muito espaço em disco, então ... vamos colocar estes dados em um sistema de armazenamento externo, como os containers que vamos utilizar todos rodam sobre algum linux ou unix, vamos ter que apontar um storage externo como ponto de montagem no sistema de arquivos do container, por isso vamos utilizar a opção -v (volume) do docker, a opção -p dos comandos abaixo está expondo a porta do container no host para que possamos acessar via host estes containeres.
Vamos criar a rede para os nossos containeres, a rede de analise de dados danet e já vamos criar os três containeres de bancos de dados, mas porque vamos criar os três já? Para consumir os recursos! Ou você pode executar cada um de maneira independente e garantir fazer com que os outros não estejam sendo executados, o que é melhor, mas por hora vou criar os três sem usá-los efetivamente.
docker network list
docker network prune
docker network create danet
docker run --name mysql    --network danet -e MYSQL_ROOT_PASSWORD=root   -p 3306:3306 -d mysql
docker run --name postgres --network danet -e POSTGRES_PASSWORD=postgres -p 5432:5432 -d postgres
docker run --name mongo    --network danet -e MONGO_INITDB_ROOT_USERNAME=mongoadmin -e MONGO_INITDB_ROOT_PASSWORD=secret -p 27017:27017 -d mongo
No Windows
Supondo que vamos utilizar o disco X, com a pasta tmp e uma subpasta para cada container fica como abaixo. Não se esqueça de criar os diretórios antes no host antes.
docker run --name mysql    --network danet -e MYSQL_ROOT_PASSWORD=root   -p 3306:3306 -v "X:\tmp\mysql\data:/var/lib/mysql" -d mysql
docker run --name postgres --network danet -e POSTGRES_PASSWORD=postgres -p 5432:5432 -v "X:\tmp\postgresql\data:/var/lib/postgresql" -d postgres
docker run --name mongo    --network danet -e MONGO_INITDB_ROOT_USERNAME=mongoadmin -e MONGO_INITDB_ROOT_PASSWORD=secret -p 27017:27017 "X:\tmp\mongo\data:/data/db" -d mongo
No Mac ou Linux
Supondo o ponto do storage em /tmp/data. Não se esqueça de criar os diretórios antes no host antes.
docker run --name mysql    --network danet -e MYSQL_ROOT_PASSWORD=root   -p 3306:3306 -v "/tmp/mysql/data:/var/lib/mysql" -d mysql
docker run --name postgres --network danet -e POSTGRES_PASSWORD=postgres -p 5432:5432 -v "/tmp/postgresql/data:/var/lib/postgresql" -d postgres
docker run --name mongo    --network danet -e MONGO_INITDB_ROOT_USERNAME=mongoadmin -e MONGO_INITDB_ROOT_PASSWORD=secret -p 27017:27017 "/tmp/mongo/data:/data/db" -d mongo
Criando os bancos de dados
Pois bem, agora vamos criar os bancos de dados, tem uma questão agora que...
Mysql
docker exec -i mysql mysql -uroot -proot -e "
CREATE DATABASE fleet;
CREATE USER 'fleet_analyst'@'%' IDENTIFIED BY 'superSecret';
GRANT ALL PRIVILEGES ON fleet.* TO 'fleet_analyst'@'%';
FLUSH PRIVILEGES;
"
Postgres
docker exec -i postgres psql -U postgres << 'EOF'
CREATE USER fleet_analyst WITH PASSWORD 'superSecret';
CREATE DATABASE fleet OWNER fleet_analyst;
EOF
MongoDB
docker exec -i mongo mongosh -u mongoadmin -p secret --authenticationDatabase admin --eval "
  db = db.getSiblingDB('fleet');
  db.createUser({
    user: 'fleet_analyst',
    pwd: 'superSecret',
    roles: [{ role: 'readWrite', db: 'fleet' }]
  });
"
Tudo lindo até aqui, temos os três servidores executando em nossa máquina tendo instalado apenas o docker, agora vamos criar uma máquina com o cliente que lerá os arquivos e vai inserir os dados nos bancos de dados. Esta máquina vai ser um container do docker.
Vamos criar uma pasta importing_data e lá terá alguns arquivos:
- importing_data/Dockerfile < o arquivo de configuração e montagem da imagem do cliente.
- importing_data/import_access.py < o arquivo que importa os dados quando a origem é um arquivo access.
- importing_data/import_csv.py < o arquivo que importa os dados quando a origem é um arquivo CSV.
- importing_data/save_to_mongo.py
- importing_data/save_to_mysql.py
- importing_data/save_to_postgres.py
Vamos criar um Dockerfile que faz um pouco mais que os nossos comandos do docker anterior, agora vamos montar uma imagem nossa com as bibliotecas do Python para executar a importação.
FROM python:3.11-slim

# Instala o mdbtools (necessário para ler arquivos .mdb/.accdb no Linux)
RUN apt-get update && apt-get install -y \
    mdbtools \
    && rm -rf /var/lib/apt/lists/*

# Instala as bibliotecas do Python
RUN pip install --no-cache-dir pandas pandas-access pymongo PyMySQL SQLAlchemy psycopg2-binary

WORKDIR /app
Criando a imagem:
docker build -t data-ingestion .Criando um script em python para ler os primeiros arquivos que estão no Access para inserir nos três bancos de dados.
Arquivo import_access.py
import io
import subprocess
import pandas as pd
import argparse
from pathlib import Path
import sys
from datetime import datetime
from time import perf_counter

from save_to_mongo import save_to_mongo
from save_to_mysql import save_to_mysql
from save_to_postgres import save_to_postgres

LOG_PATH = Path(__file__).with_name("out.log")


def log_message(message: str):
    line = f"[{datetime.now().isoformat(timespec='milliseconds')}] {message}"
    with LOG_PATH.open("a", encoding="utf-8") as file:
        file.write(line + "\n")
    print(message)

# Setup argument parser
parser = argparse.ArgumentParser(description='Import data from an Access database to MongoDB.')
parser.add_argument('month', type=str, help='The month of the data in "yyyy-mm" format.')
args = parser.parse_args()


path_mdb = Path("/data/arquivo.mdb")
path_accdb = Path("/data/arquivo.accdb")

start_total = perf_counter()

if path_mdb.is_file():
    mdb_path = str(path_mdb)
elif path_accdb.is_file():
    mdb_path = str(path_accdb)
else:
    log_message("No file found")
    sys.exit()

# 1. Lista as tabelas usando mdb-tables com delimitador de quebra de linha (-1)
# Isso impede que o mdbtools se confunda com os espaços no nome da tabela!
output_tables = subprocess.check_output(["mdb-tables", "-1", mdb_path]).decode("utf-8")
tabelas = [t.strip() for t in output_tables.splitlines() if t.strip()]

log_message("Tabelas reais encontradas:")
log_message(str(tabelas))

if tabelas:
    nome_tabela = tabelas[0]
    log_message(f"\nExportando e carregando a tabela: '{nome_tabela}'...")

    # 2. Executa o mdb-export para converter a tabela diretamente para um fluxo CSV
    csv_bytes = subprocess.check_output(["mdb-export", mdb_path, nome_tabela])

    # 3. Carrega o CSV direto para o DataFrame do pandas sem salvar em disco
    header_row = 1 if mdb_path.lower().endswith('.accdb') else 0 # Se for .accdb, ignora a primeira linha de cabeçalho
    df = pd.read_csv(io.BytesIO(csv_bytes), header=header_row)

    # 4. Add the 'month' column
    df['month'] = args.month

    # Como as colunas as vezes mudam de nome, vamos renomear para um padrão que vamos utilizar em todos os arquivos.
    df.rename(
        columns={
            'UF': 'state',
            'MunicÃ\xadpio': 'city',
            'Ano Fabricação VeÃ\xadculo CRV': 'makeYear',
            'Qtd. VeÃ\xadculos': 'Qtd. Veículos'
        },
        inplace=True
    )

    # Como as colunas as vezes mudam de nome, vamos renomear para um padrão que vamos utilizar em todos os arquivos.
    df.rename(
        columns={
            'MUNICÍPIO': 'city',
            'MARCA MODELO': 'brandModel',
            'Ano Fabricação VeÃ\xadculo CRV': 'makeYear',
            'QT DE VEÍCULOS': 'quantity'
        },
        inplace=True
    )

    # Como as colunas as vezes mudam de nome, vamos renomear para um padrão que vamos utilizar em todos os arquivos.
    df.rename(
        columns={
            'Município': 'city',
            'Marca Modelo': 'brandModel',
            'Ano Fabricação Veículo CRV': 'makeYear',
            'Qtd. Veículos': 'quantity'
        },
        inplace=True
    )

    if header_row == 1:
        df.drop(columns=['1'], inplace=True)

    log_message("\nDataFrame carregado com sucesso!")
    log_message(str(df.head()))
    log_message(f"\nTotal de linhas: {len(df)}")

    log_message("\nColumns : ")
    log_message(str(df.describe()))
    log_message("\n")

    log_message("\nColumns : ")
    log_message(str(df.columns.tolist()))
    log_message("\n")

    save_to_mongo(df)
    save_to_postgres(df)
    save_to_mysql(df)

    elapsed_ms = round((perf_counter() - start_total) * 1000)
    log_message(f"Tempo total de processamento: {elapsed_ms} ms")
else:
    log_message("Nenhuma tabela encontrada.")
    elapsed_ms = round((perf_counter() - start_total) * 1000)
    log_message(f"Tempo total de processamento: {elapsed_ms} ms")
Arquivo save_to_postgres.py
from datetime import datetime
from pathlib import Path
from time import perf_counter
from urllib.parse import quote

import pandas as pd
from sqlalchemy import create_engine

#postgres_url = "postgresql+psycopg2://fleet_analyst:%s@127.0.0.1:5432/fleet" % quote("superSecret")
postgres_url = "postgresql+psycopg2://fleet_analyst:%s@postgres:5432/fleet" % quote("superSecret")
LOG_PATH = Path(__file__).with_name("out.log")


def log_message(message: str):
    line = f"[{datetime.now().isoformat(timespec='milliseconds')}] {message}"
    with LOG_PATH.open("a", encoding="utf-8") as file:
        file.write(line + "\n")
    print(message)


def save_to_postgres(df: pd.DataFrame, url: str = postgres_url, table_name: str = "fleet"):
    start = perf_counter()

    if df is None or df.empty:
        log_message("DataFrame vazio. Nenhum registro enviado ao PostgreSQL.")
        return 0

    engine = create_engine(url)
    with engine.begin() as connection:
        df.to_sql(table_name, connection, if_exists="append", index=False)

    elapsed_ms = round((perf_counter() - start) * 1000)
    log_message(f"{len(df)} registros enviados ao PostgreSQL na tabela '{table_name}' em {elapsed_ms} ms.")
    return len(df)
Arquivo save_to_mongo.py
from datetime import datetime
from pathlib import Path
from time import perf_counter
from urllib.parse import quote

import pandas as pd
from pymongo import MongoClient

#mongo_url = "mongodb://fleet_analyst:%s@127.0.0.1:27017/fleet?authSource=admin" % quote("superSecret")
mongo_url = "mongodb://fleet_analyst:%s@mongo:27017/fleet?authSource=fleet" % quote("superSecret")
LOG_PATH = Path(__file__).with_name("out.log")


def log_message(message: str):
    line = f"[{datetime.now().isoformat(timespec='milliseconds')}] {message}"
    with LOG_PATH.open("a", encoding="utf-8") as file:
        file.write(line + "\n")
    print(message)


def save_to_mongo(df: pd.DataFrame, url: str = mongo_url, database: str = "fleet", collection_name: str = "fleet"):
    start = perf_counter()

    if df is None or df.empty:
        log_message("DataFrame vazio. Nenhum registro enviado ao MongoDB.")
        return 0

    client = MongoClient(url)
    db = client[database]
    collection = db[collection_name]

    records = df.where(pd.notna(df), None).to_dict(orient="records")
    if not records:
        log_message("Nenhum registro válido para inserir no MongoDB.")
        return 0

    result = collection.insert_many(records)
    elapsed_ms = round((perf_counter() - start) * 1000)
    log_message(f"{len(result.inserted_ids)} registros enviados ao MongoDB em '{database}.{collection_name}' em {elapsed_ms} ms.")
    return len(result.inserted_ids)
O arquivo save_to_mysql.py é muito parecido com o arquivo que grava os dados no Postgres, mas de qualquer forma vou deixar ele inteiro aqui.
from datetime import datetime
from pathlib import Path
from time import perf_counter
from urllib.parse import quote

import pandas as pd
from sqlalchemy import create_engine

#mysql_url = "mysql+pymysql://fleet_analyst:%s@127.0.0.1:3306/fleet" % quote("superSecret")
mysql_url = "mysql+pymysql://fleet_analyst:%s@mysql:3306/fleet" % quote("superSecret")
LOG_PATH = Path(__file__).with_name("out.log")


def log_message(message: str):
    line = f"[{datetime.now().isoformat(timespec='milliseconds')}] {message}"
    with LOG_PATH.open("a", encoding="utf-8") as file:
        file.write(line + "\n")
    print(message)


def save_to_mysql(df: pd.DataFrame, url: str = mysql_url, table_name: str = "fleet"):
    start = perf_counter()

    if df is None or df.empty:
        log_message("DataFrame vazio. Nenhum registro enviado ao MySQL.")
        return 0

    engine = create_engine(url)
    with engine.begin() as connection:
        df.to_sql(table_name, connection, if_exists="append", index=False)

    elapsed_ms = round((perf_counter() - start) * 1000)
    log_message(f"{len(df)} registros enviados ao MySQL na tabela '{table_name}' em {elapsed_ms} ms.")
    return len(df)
Um detalhe interessante nestes scritps do python é a url de conexão, pois bem nós criamos uma rede e na url o nome depois do @ é o nome do container, importante manter isso alinhado senão o container que lê os dados pode não econtrar o banco de dados que estiver tratando no momento.
Vamos importar os arquivos:
"Quantidade de Veiculos Por UF Municipio e Marca_Modelo_JUL_2013.mdb"
"I_Frota_por_UF_Municipio_Marca_e_Modelo_Ano_Julho_2019.accdb"
"I_Frota_por_UF_Municipio_Marca_e_Modelo_Julho_2018.accdb"
docker run --network danet --rm -v "/Volumes/dados/fleet/Quantidade de Veiculos Por UF Municipio e Marca_Modelo_JUL_2013.mdb:/data/arquivo.mdb" -v "$(pwd):/app" data-ingestion python import_access.py 2013-07
docker run --network danet --rm -v "/Volumes/dados/fleet/I_Frota_por_UF_Municipio_Marca_e_Modelo_Ano_Julho_2019.accdb:/data/arquivo.accdb" -v "$(pwd):/app" data-ingestion python import_access.py 2019-07
docker run --network danet --rm -v "/Volumes/dados/fleet/I_Frota_por_UF_Municipio_Marca_e_Modelo_Julho_2018.accdb:/data/arquivo.accdb" -v "$(pwd):/app" data-ingestion python import_access.py 2018-07